Herramientas y stack tecnológico
El stack concreto implementa lo que cada syllabus llamaRequisitos técnicos y plataforma: cuadernos y APIs (08–09), diagramación y repo (10), nubes + contenedores + CI (11), concontingencia local (LM Studio / Ollama) cuando cae el proveedor.
Base local (todos los cursos)
- LM Studio— Servidor local recomendado para labs (puerto 1234).
lms server start --port 1234 - Ollama— Alternativa local; misma familia de scripts vía OPENAI_BASE_URL.
- Python 3.11+— Runtime de labs/smoke sin dependencias pesadas obligatorias.
- Git— Versionar prompts, design docs y canalizaciones.
Arranque rápido LM Studio
export OPENAI_BASE_URL=http://localhost:1234/v1
export OPENAI_API_KEY=lm-studio
export OPENAI_MODEL=google/gemma-4-e4b
make smoke          # o: python3 labs/smoke_local.py
make lab-08-u04     # dual-stack costo abierto vs cerrado + rúbrica
make lab-09-u01-compaction  # bloat→compact (SII) + rúbrica
make lab-09-u02     # regresión + rúbrica → labs/09/runs/
make lab-09-u04-harness     # from-scratch vs harness (ClaveÚnica)
make labs-09        # u01→compaction→u04→harness
make lab-11-u01     # health + rúbrica (exit 2 si excede presupuesto chat)
Makefile en la raíz: un comando por lab (market #4). Eval-first: labs/RUBRIC.md · claims 10: labs/10/claims_eval.md · referentes: references/referents/.
Evidencia de corrida
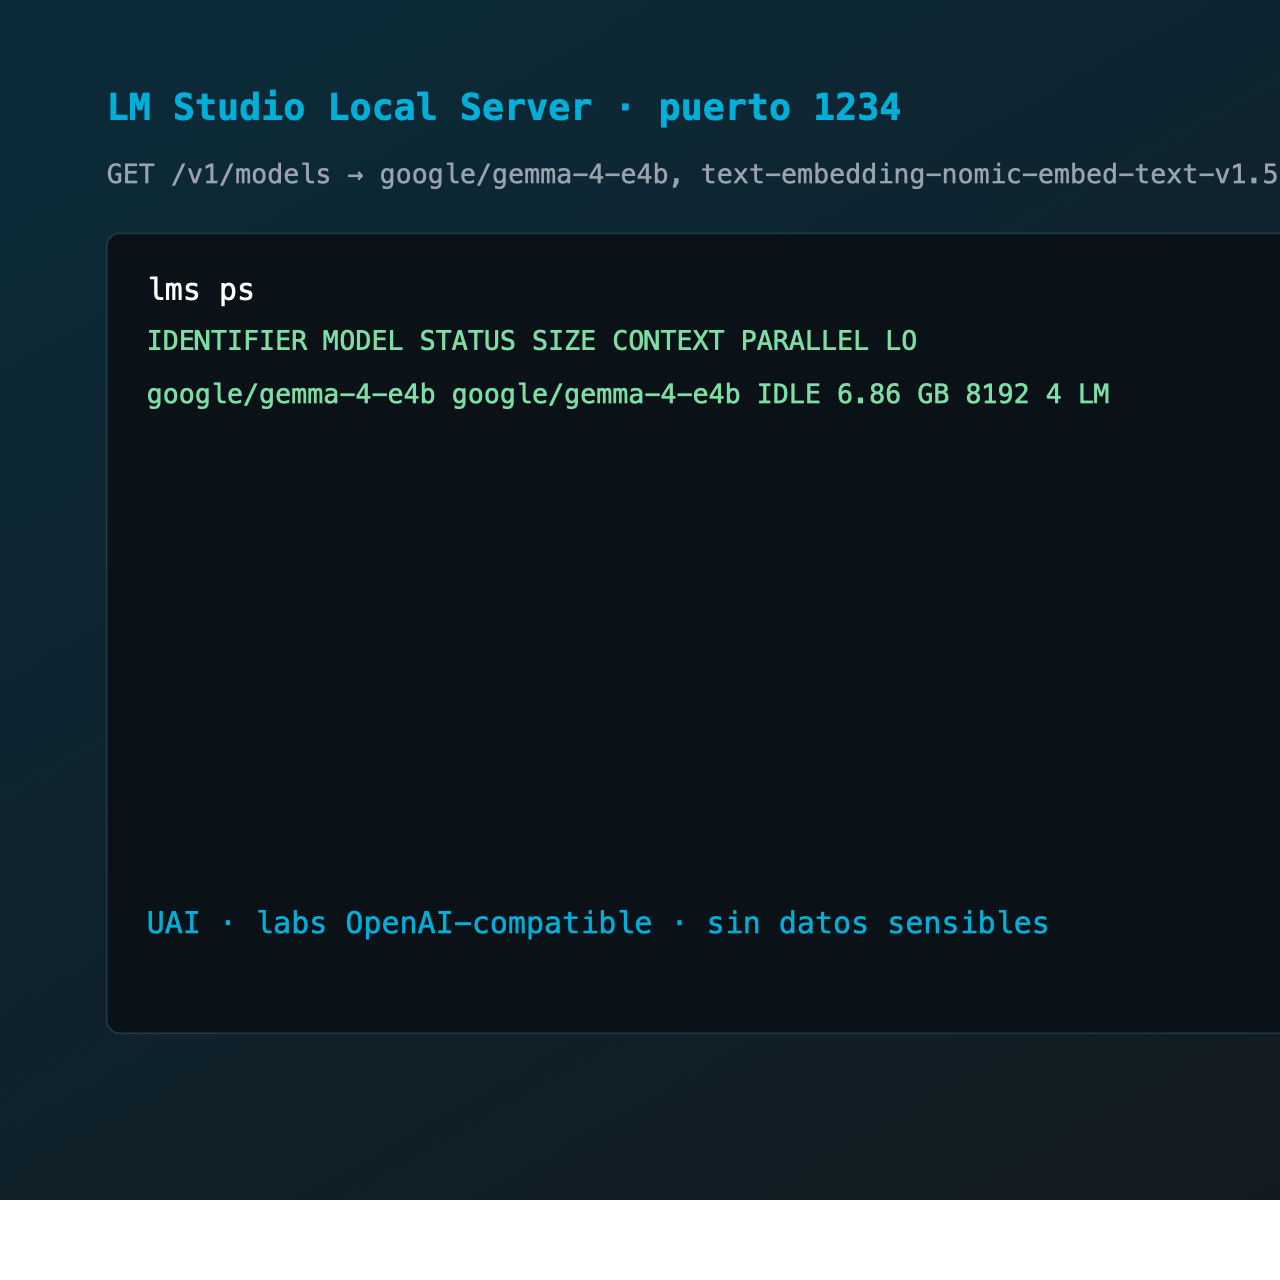
- 11/u01 health— LM Studio · gemma-4-e4b · /health JSON
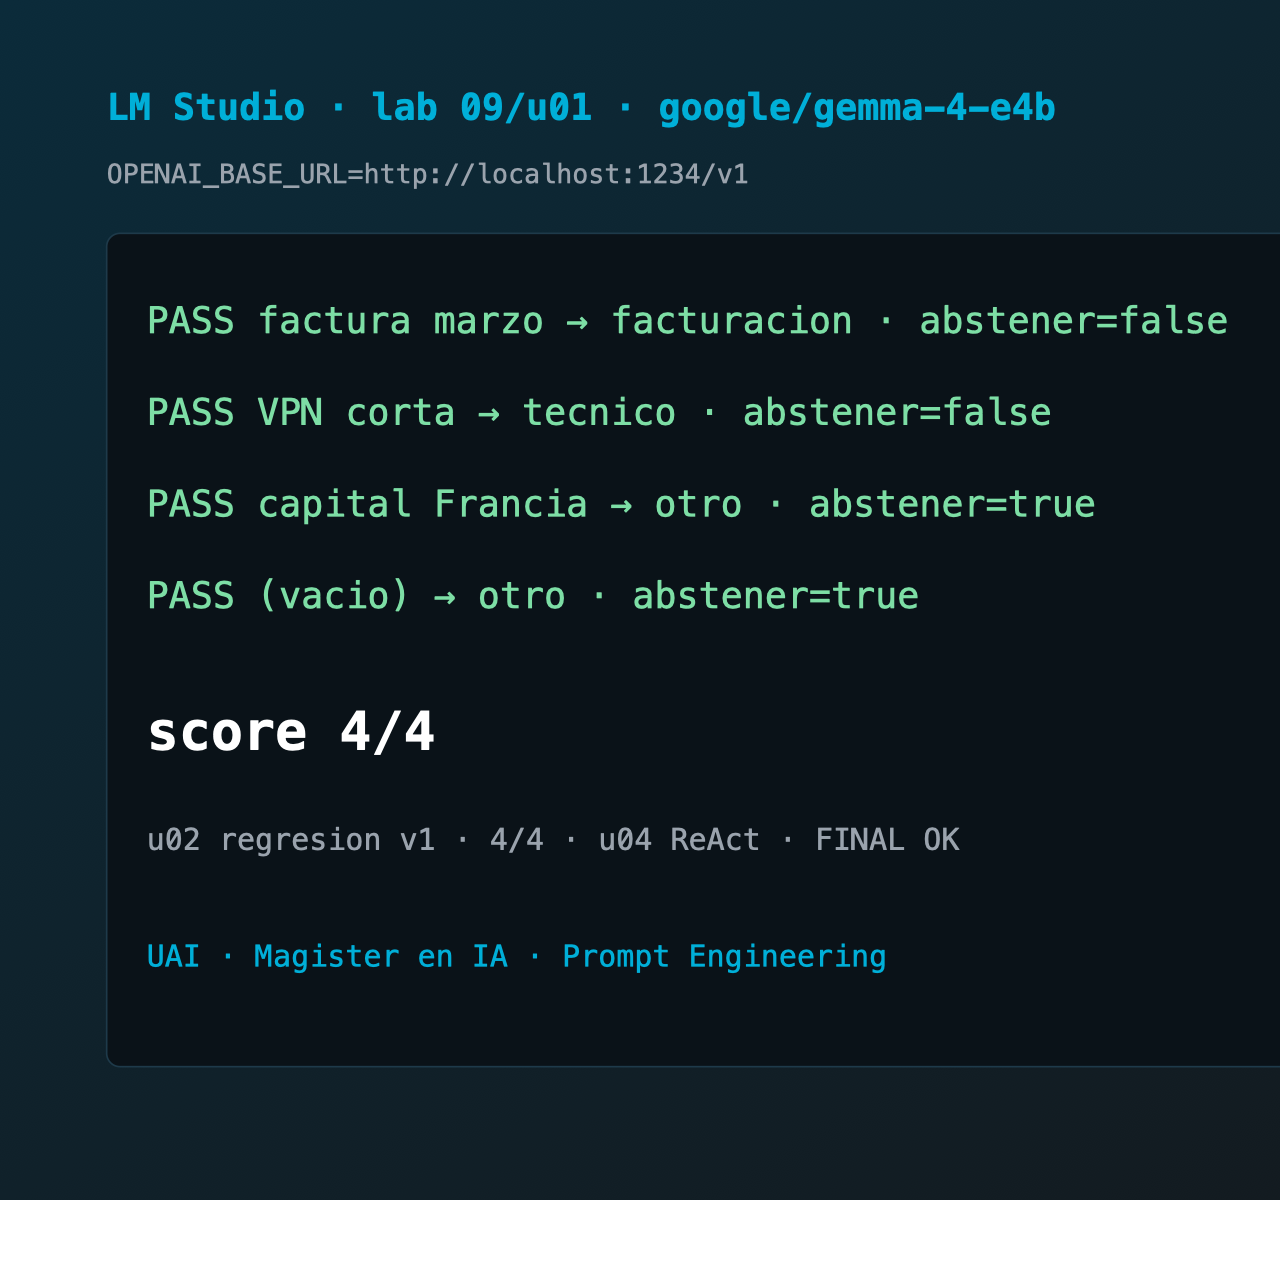
- 09/u01 structured— score 4/4 · abstención OOD
- 09/u02 regression— score 4/4 · prompt=v1
- 09/u03 verify— score 3/3 · verificación programática
- 09/u04 agent— ReAct · file_read → calculator → finish
Curso 08 ver programa
Cuadernos con cómputo acelerado + APIs de modelos cerrados + pesos abiertos locales (contingencia en CPU).
Cuadernos gestionados (GPU)
Syllabus: Entorno de ejecución — cómputo acelerado
- Google Colab— Cuadernos con GPU/TPU para experimentos con pesos abiertos.
Runtime → GPU. Preferir programas académicos / límites de cuota. - Kaggle Notebooks— Alternativa con cuotas de GPU semanales y datasets públicos.
- Jupyter Lab (local)— Misma disciplina de cuaderno cuando la GPU es la del estudiante.
Pesos abiertos (local / hub)
Syllabus: Modelos abiertos · contingencia CPU
- LM Studio— Servidor local OpenAI-compatible; demos y contingencia sin cloud.
lms server start · http://localhost:1234/v1 - Ollama— Pull/run de instruct locales; API /v1.
ollama pull gemma3 · http://localhost:11434/v1 - Hugging Face Hub + transformers— Descarga de pesos, tokenizers y notebooks de referencia.
- llama.cpp— Inferencia cuantizada liviana en CPU cuando cae la GPU gestionada.
Modelos de acceso cerrado (API)
Syllabus: Interfaces de programación de proveedores · Unidad 4
- OpenAI API— Comparación cerrado vs abierto (calidad, costo, latencia).
Clave por equipo, crédito prepagado, sin facturación del estudiante. - Anthropic API— Segundo proveedor cerrado para migración / contingencia.
- Google AI Studio / Gemini API— Tercer proveedor; programas académicos cuando existan.
Curso 09 ver programa
Cuadernos + APIs por token (sin entrenamiento). Contingencia: modelo local. Agentes solo con tools en sandbox.
Runtime de prompts y agentes
Syllabus: Entorno de ejecución · consumo por token
- LM Studio / Ollama— Labs del repo (`labs/09/*`) contra API OpenAI-compatible.
OPENAI_BASE_URL=http://localhost:1234/v1 - Python 3 + scripts del repo— Suites de regresión, CoT+verify y agente ReAct sin framework obligatorio.
python labs/09/u01/run_structured.py - Proveedor cloud (clave de equipo)— Talleres cuando la UAI provee cuota; medir costo por tarea (U6).
Herramientas del agente (sandbox)
Syllabus: Herramientas del agente · privilegio mínimo
- calculator / file_read (labs/09/u04)— Tools de ejemplo aisladas; sin escritura a sistemas reales.
- Datos sintéticos / públicos— Nunca PII ni datos de la organización del estudiante en terceros.
Marcos opcionales (verificar al dictado)
Syllabus: Nota de vigencia de marcos agénticos
- LangGraph / LlamaIndex (opcional)— Ilustración de topologías; el curso exige el método, no un vendor.
- Open WebUI— Chat UI sobre Ollama/LM Studio para demos en clase.
Curso 10 ver programa
Sin cómputo especializado ni cuentas cloud: diagramación + repo del design doc. Costos desde listas oficiales.
Documento de diseño
Syllabus: Entorno de ejecución — repositorio + diagramación
- Git + GitHub— Versionar el design doc e iteraciones por unidad.
- Markdown / Notion / Google Docs— Redacción del entregable; exportable a PDF para defensa.
- Mermaid— Diagramas de arquitectura en el mismo repo (CI-friendly).
Bloques ```mermaid en el design doc. - draw.io / diagrams.net— Diagramas de despliegue y topologías cuando Mermaid no alcanza.
- Excalidraw— Bocetos de interacción humano-IA en taller.
Referencias de costo (sin aprovisionar)
Syllabus: Referencias de costo — calculadoras oficiales
- Calculadoras AWS / Azure / GCP— Presupuestos unitarios de la Unidad 1 sin crear cuentas de pago.
- Listas de precios de APIs generativas— Costo por token / request para justificar NFR.
Curso 11 ver programa
Tres nubes + CI + contenedores locales. Cada lab declara alternativa local (p.ej. LM Studio).
Proveedores de nube (programas académicos)
Syllabus: Cuentas en los tres proveedores principales
- AWS (Academy / Educate)— Entrenamiento, registry, serving e IAM con crédito fijo.
- Microsoft Azure (for Students / Azure ML)— Workspace, endpoints y Key Vault para secretos.
- Google Cloud (Education / Vertex AI)— Pipelines, Model Registry y monitoring.
Local + integración continua
Syllabus: Entorno local con contenedores · repositorio con CI
- Docker— Empaquetar el servicio de inferencia / healthcheck.
Imagen con healthcheck; sin secretos en capas. - GitHub Actions— Build, test y smoke del wrapper (labs/11/u01).
- LM Studio (contingencia)— Backend OpenAI-compatible cuando la nube no está disponible.
python labs/11/u01/health_wrapper.py
Observabilidad y secretos
Syllabus: Gestión de credenciales · monitoreo (U2/U4)
- Secret managers (AWS SM / Azure Key Vault / GCP SM)— Sin credenciales de larga duración en el repo.
- Dashboards nativos + alertas de presupuesto— Contenido y control de gasto desde la Unidad 1.
Otras piezas opcionales
- llama.cpp — inferencia cuantizada en CPU (contingencia 08).
- Open WebUI — chat sobre Ollama/LM Studio para demos.
- vLLM / TGI — serving de alto throughput (contexto curso 11; no obligatorio en labs locales).