Magíster en Inteligencia Artificial
Salir de la clase

Curso 09 · Unidad 2


El prompt como artefacto

4 hrs · Versionado, sensibilidad y regresión — UAI

Tesis

Si no está en el repo, no es ingeniería

  • El prompt es un artefacto versionado junto al código.
  • Cambios “semánticamente neutros” pueden mover el score.
  • Sin suite de regresión, cada modelo nuevo es un salto al vacío.
  • Medimos pass rate + varianza, no “se ve bien”.

Al finalizar

Resultados de aprendizaje

  • Medir sensibilidad a variaciones de formato.
  • Versionar prompts y correr pruebas de regresión.
  • Detectar degradación por cambio de modelo o de prompt.

Bloque 1 · 60 min

Sensibilidad al formato

Teoría

Sensibilidad a features espurias

  • Sclar et al. (2024): separadores, mayúsculas y orden pueden mover el score tanto como cambiar de modelo.
  • Schulhoff et al. (2024): la “ingeniería de prompts” exige medir, no solo reescribir.
  • Implicación: el formato canónico vive en el repo; “mismo significado” no implica misma salida.

Evidencia

Sclar et al.: features espurias

  • Separadores, mayúsculas y orden pueden valer tanto como cambiar de modelo.
  • No asumir que “mismo significado ⇒ misma salida”.
  • Documentar el formato canónico en el repo.

Ilustración

Misma tarea, tres formatos

Ilustrativo: el formato canónico se versiona; no se improvisa en producción.

Bloque 2 · 60 min

Suites de prueba

Definiciones

Golden set y regresión

  • Golden set — batería versionada de entradas con resultado esperado (pass/fail).
  • Regresión de prompt — re-correr el set al cambiar prompt, modelo o temperatura.
  • Rúbrica — dimensiones medibles (formato · calidad · seguridad · costo), no “se ve bien”.

Diseño

Qué meter en la batería

  • Casos felices + casos límite + fuera de alcance.
  • Criterios automatizables (JSON schema, campos esperados).
  • Repeticiones cuando la temperatura no es cero.
  • Tamaño suficiente para detectar caídas relevantes.

Ilustración

Set → corrida → veredicto

Sin golden set versionado, cada modelo nuevo es un salto al vacío.

Bloque 3 · 60 min

Versionado y regresión

Lab vivo

prompts/v1.md + cases.yaml + rúbrica

Lab: labs/09/u02/run_regression.py contra LM Studio — reporta formato · calidad · seguridad · costo (labs/09/RUBRIC.md) y escribe labs/09/runs/u02-regression-report.json.

Cualquier cambio de prompt o modelo debe re-correr la suite; el pass no es “se ve bien”.

Evidencia local
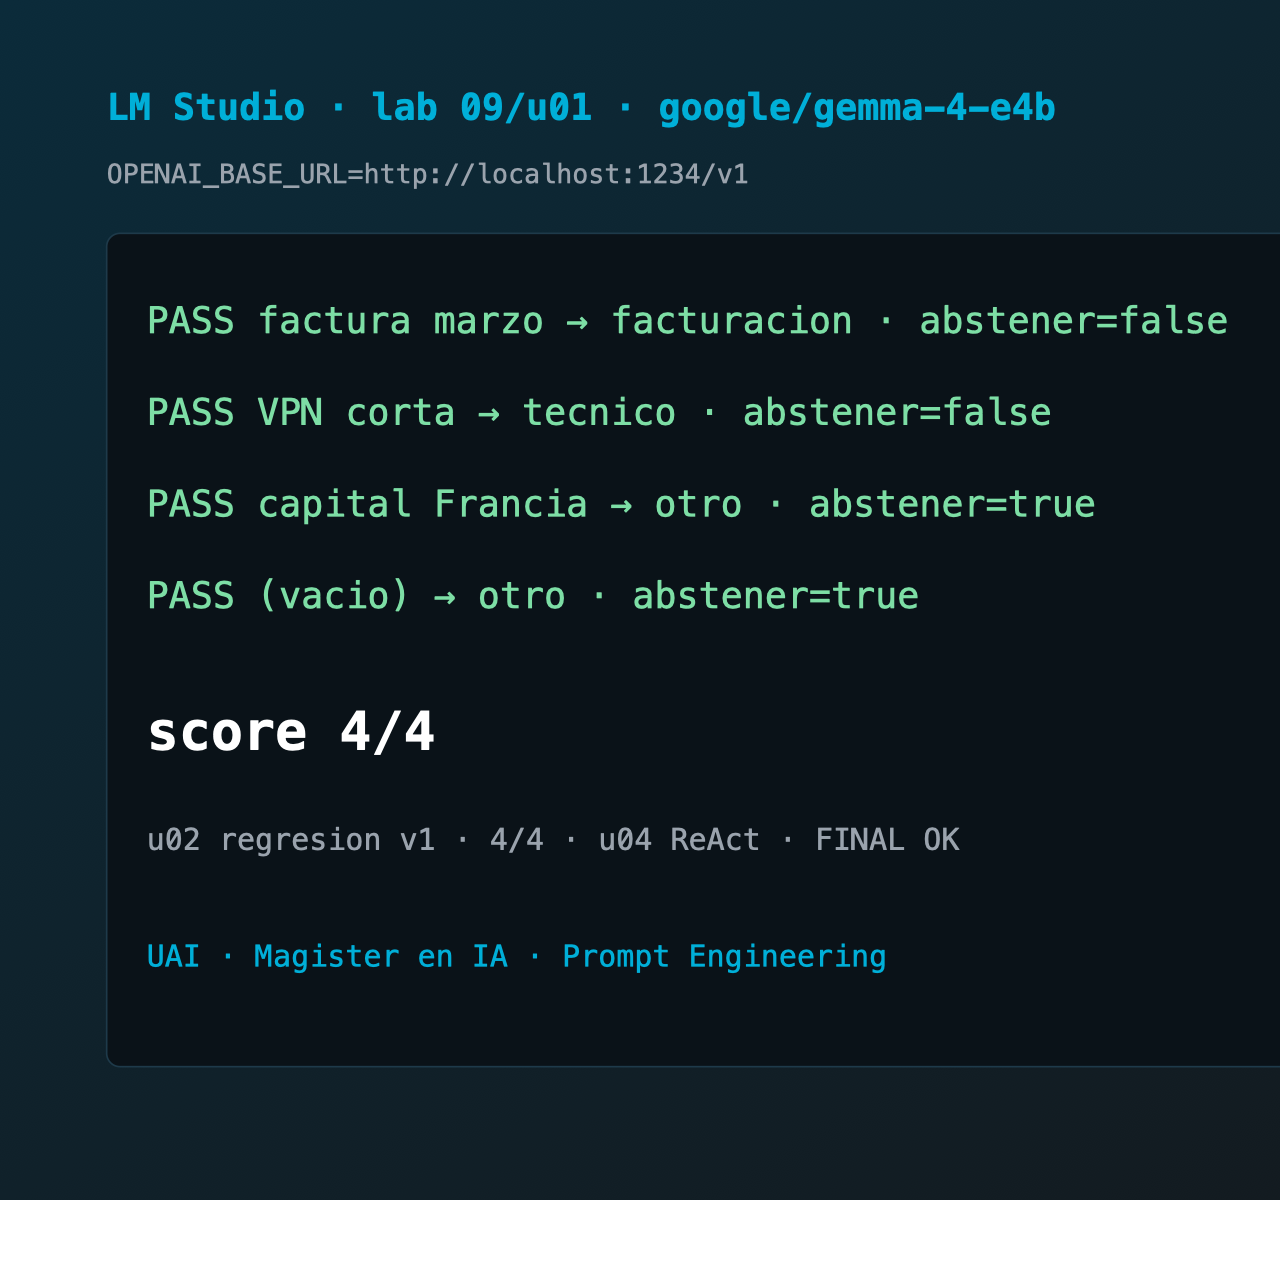
Misma stack, lab estructurado

Resultado 4/4 del lab de clasificación contra LM Studio gemma-4-e4b

Base reutilizada por u01/u02: salida JSON + abstención · localhost:1234

Bloque 4 · 60 min

Taller 1 / Eval 1

Dominio

Caso Chile en la batería

  • Soporte en español: boleta SII, ClaveÚnica, VPN.
  • PII de terceros → abstención (RUT, sueldo): el flujo importa más que el modelo.
  • Lab: labs/09/u02/cases.yaml (golden set local).

Entregable

Optimización sistemática

  • Prompt versionado (v1 → v2) con diff legible.
  • Batería YAML + script de regresión (rúbrica 09).
  • Tabla: modelo × temperatura × pass rate.
  • Análisis breve de sensibilidad (1–2 variantes de formato).

Juez

El score también tiene sesgo

Si usás LLM-as-judge en la suite: swap, rúbrica y muestra humana.

Lecturas

Para profundizar

  • Sclar et al. (2024) — sclar2024sensitivity
  • Schulhoff et al. (2024) — schulhoff2024prompt

Cierre


Preguntas

Siguiente: razonamiento, descomposición y verificación (Unidad 3)