Magíster en Inteligencia Artificial
Salir de la clase

Curso 11 · Unidad 3


Inferencia y despliegue

4 hrs · Serving · canary · orquestación — UAI

Tesis

Implementar lo que el curso 10 especificó

  • El patrón de servicio se deriva de los NFR.
  • Promoción/reversión deben ser automáticas.
  • Cold start incumple presupuestos de latencia.
  • Contingencia local: LM Studio + Docker + Actions.

Al finalizar

Resultados de aprendizaje

  • Seleccionar patrón de servicio (batch/online/stream/edge).
  • Configurar autoscaling y mitigar cold start.
  • Implementar despliegue progresivo con criterios de rollback.

Bloque 1 · 60 min

Patrones

Teoría

Serving desde NFR

  • Huyen (2022), caps. 7 y 9: el patrón de servicio se deriva de latencia/costo/volumen.
  • Kreuzberger et al. (2023): serving y deployment son componentes del mapa MLOps.
  • Promoción/reversión automáticas — no chat bajo presión.

Serving

Dimensionamiento

  • Batch, online, streaming, edge.
  • Instancia, autoscaling, batching vs latencia individual.
  • Cold start y mitigaciones.
  • Cuándo justifica acelerador especializado.

Definiciones

Léxico de serving

  • Patrón de servicio — batch, online, streaming o edge elegido desde NFR (latencia, costo, volumen).
  • Cold start — latencia extra al despertar una instancia fría; incumple presupuestos si no se mitiga.
  • Despliegue progresivo — sombra / canaria / azul-verde con promoción y rollback por métrica.
  • Orquestación — coordinación de pasos y fallos parciales; no sustituye el diseño de NFR.

Patrones

El serving también sale del NFR

Misma lógica que en diseño (curso 10): presupuesto primero, plataforma después.

Bloque 2 · 60 min

Despliegue

Estrategias

Canaria con rollback automático

Promoción y reversión por métrica — no por chat bajo presión.

Criterios

Sombra · canaria · azul-verde

  • Criterios automáticos de promoción.
  • Criterios automáticos de reversión.
  • Registro de versiones y capacidad de retorno.
  • No decidir rollback “a mano” bajo presión.

Bloque 3 · 60 min

Orquestación

Pipelines

Dependencias y fallos parciales

  • Canalizaciones multi-paso.
  • Reintentos y compensación.
  • Conceptos de orquestación de contenedores (diálogo con plataforma).
  • No es un curso de admin de Kubernetes.

Latencia

Serving y presupuesto de tiempo

Cold start incumple TTFT si no se mitiga.

Bloque 4 · 60 min

Lab

Stack 11

Nube académica + contingencia

  • AWS / Azure / GCP (crédito fijo).
  • Dockerizar el health wrapper del lab 11/u01.
  • Smoke en GitHub Actions.
  • Caso Chile: API de scoring interna (banca/retail) — canaria 10% + rollback por latencia p95.

Lab

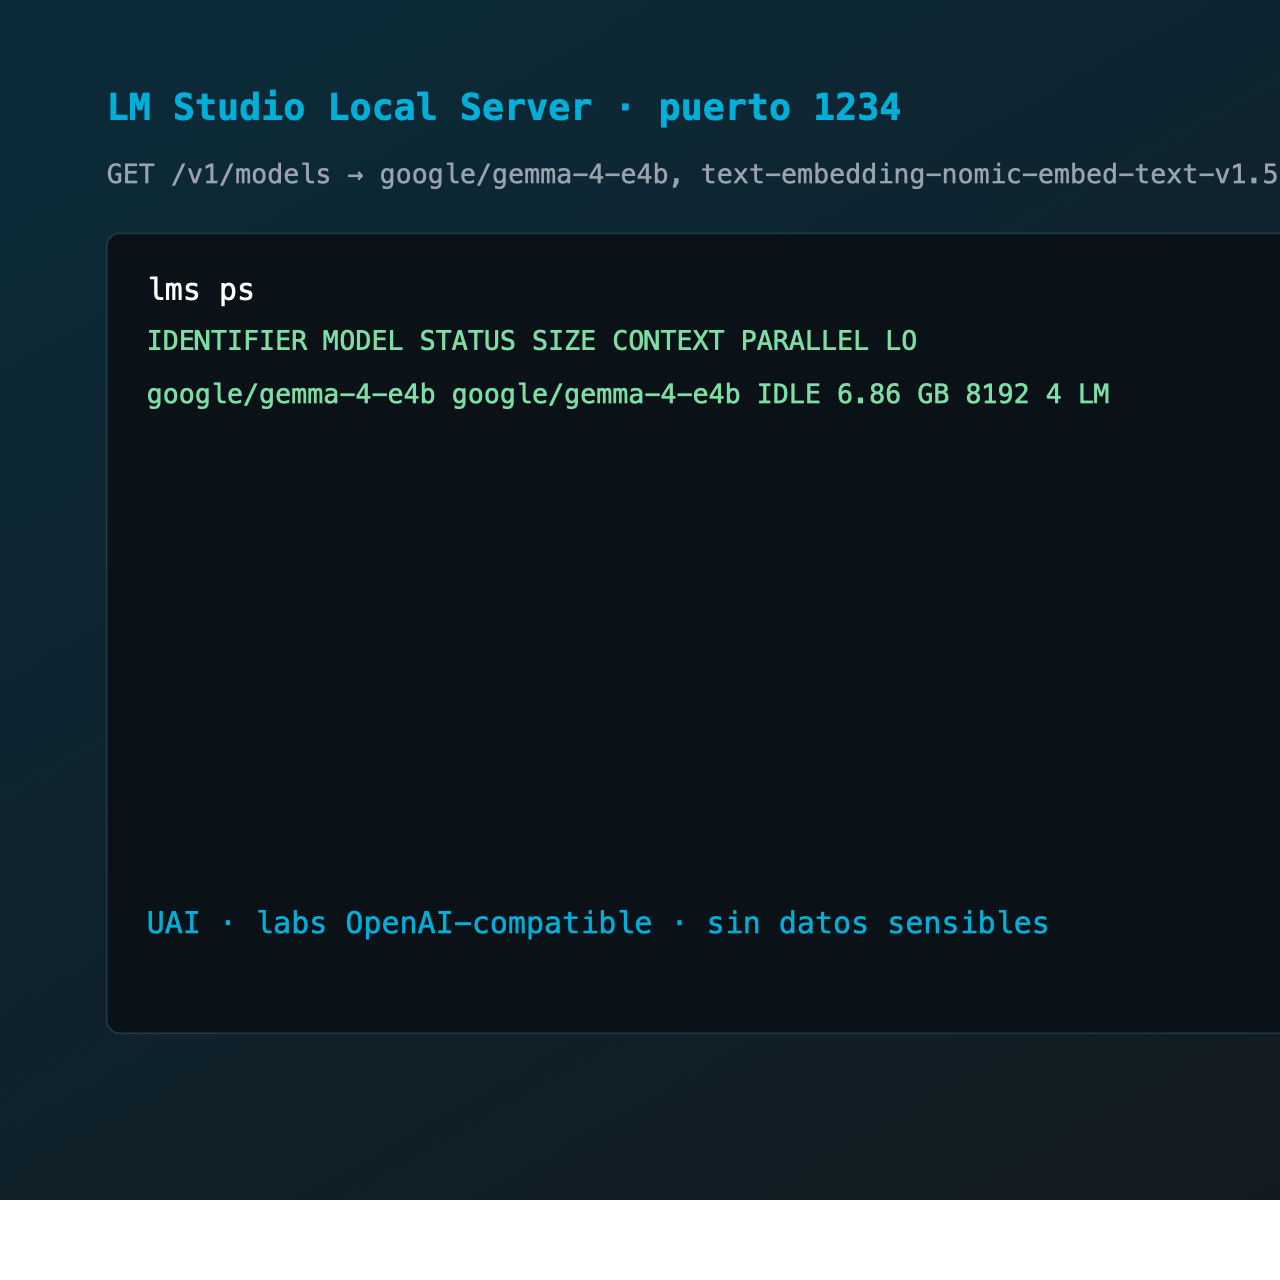
Backend local medible

LM Studio server status

Lab: labs/11/u01/health_wrapper.py · misma API OpenAI-compatible que la nube

Entregable

Smoke de despliegue

  • Health check verde en local (make smoke o wrapper 11/u01).
  • Anotar imagen/tag y fallback si cae el proveedor cloud.
  • Evidencia en labs/runs/ o captura en /herramientas.

Lecturas

Para profundizar

  • Huyen (2022), caps. 7 y 9 — huyen2022designing
  • Kreuzberger et al. (2023) — kreuzberger2023mlops
  • Burns et al. — burns2022kubernetes (complementaria; conceptos, no admin)

Cierre


Preguntas

Siguiente: observabilidad y deriva (Unidad 4)