Magíster en Inteligencia Artificial
Salir de la clase

Curso 09 · Unidad 6


Evaluación agéntica y control

4 hrs · Trayectorias e inyección — UAI

Tesis

El resultado no es la trayectoria

  • Success rate sin costo engaña.
  • El modelo no distingue instrucción de contenido recuperado.
  • Defensas solo por prompt no bastan.
  • Los controles efectivos son de arquitectura (→ curso 10).

Al finalizar

Resultados de aprendizaje

  • Evaluar trayectorias: completitud, costo, pasos, tool errors.
  • Explicar inyección directa vs indirecta.
  • Proponer controles fuera del prompt.

Bloque 1 · 60 min

Trayectorias

Teoría

Medir agentes sin autoengaño

  • Kapoor et al. (2024): success rate sin costo engaña; reportar pasos/tokens por éxito.
  • Zheng et al. (2023): LLM-as-judge tiene sesgos (longitud, posición) — no es oráculo.
  • Registrar trayectoria completa, no solo el output final.

Definiciones

Léxico de evaluación agéntica

  • Trayectoria — secuencia Thought/Action/Observation hasta finish; se evalúa completa, no solo el output.
  • Inyección directa — el usuario intenta override de la política en el mensaje.
  • Inyección indirecta — instrucciones ocultas en contenido recuperado (web, mail, doc).
  • Control de arquitectura — privilegio mínimo, validación de acciones y HITL; no un system prompt más largo.

Métricas

Qué registrar

  • Completitud de la tarea.
  • Costo / tokens / pasos por éxito.
  • Tasa de invocación errónea de tools.
  • Análisis cualitativo de fallas.

Costo

Success sin presupuesto engaña

Kapoor et al.: reportar pasos/tokens por éxito — no solo pass rate.

Bloque 2 · 60 min

Evaluación práctica

Diseño

Sets y jueces

  • Tareas con repeticiones (varianza).
  • Jueces LLM: sesgos de longitud/posición.
  • Validez externa de benchmarks públicos.
  • Reusar labs u01–u04 como núcleo medible.

Bloque 3 · 60 min

Inyección

Teoría

Inyección indirecta

  • Greshake et al. (2023): contenido recuperado puede contener instrucciones al agente.
  • El modelo no distingue de forma fiable instrucción vs dato — el prompt no es perímetro.
  • Controles efectivos: privilegio mínimo, validación de acciones, confirmación humana.

Ataque

Directa e indirecta

  • Directa: el usuario intenta override.
  • Indirecta: web/correo/doc con instrucciones al agente.
  • Superficie crece con cada tool que lee contenido externo.
  • Greshake et al. (2023) — evidencia, no anécdota.

Ilustración

Dos canales, un modelo

El prompt no separa instrucción de dato; la arquitectura sí debe hacerlo.

Bloque 4 · 60 min

Controles

Arquitectura

Fuera del prompt

  • Privilegio mínimo de tools (sandbox del lab).
  • Validación programática de acciones.
  • Separación de canales instrucción / contenido.
  • Confirmación humana para lo irreversible.

Ilustración

Controles fuera del modelo

El perímetro es arquitectura (tools, validación, HITL) — no un system prompt más largo.

Lab
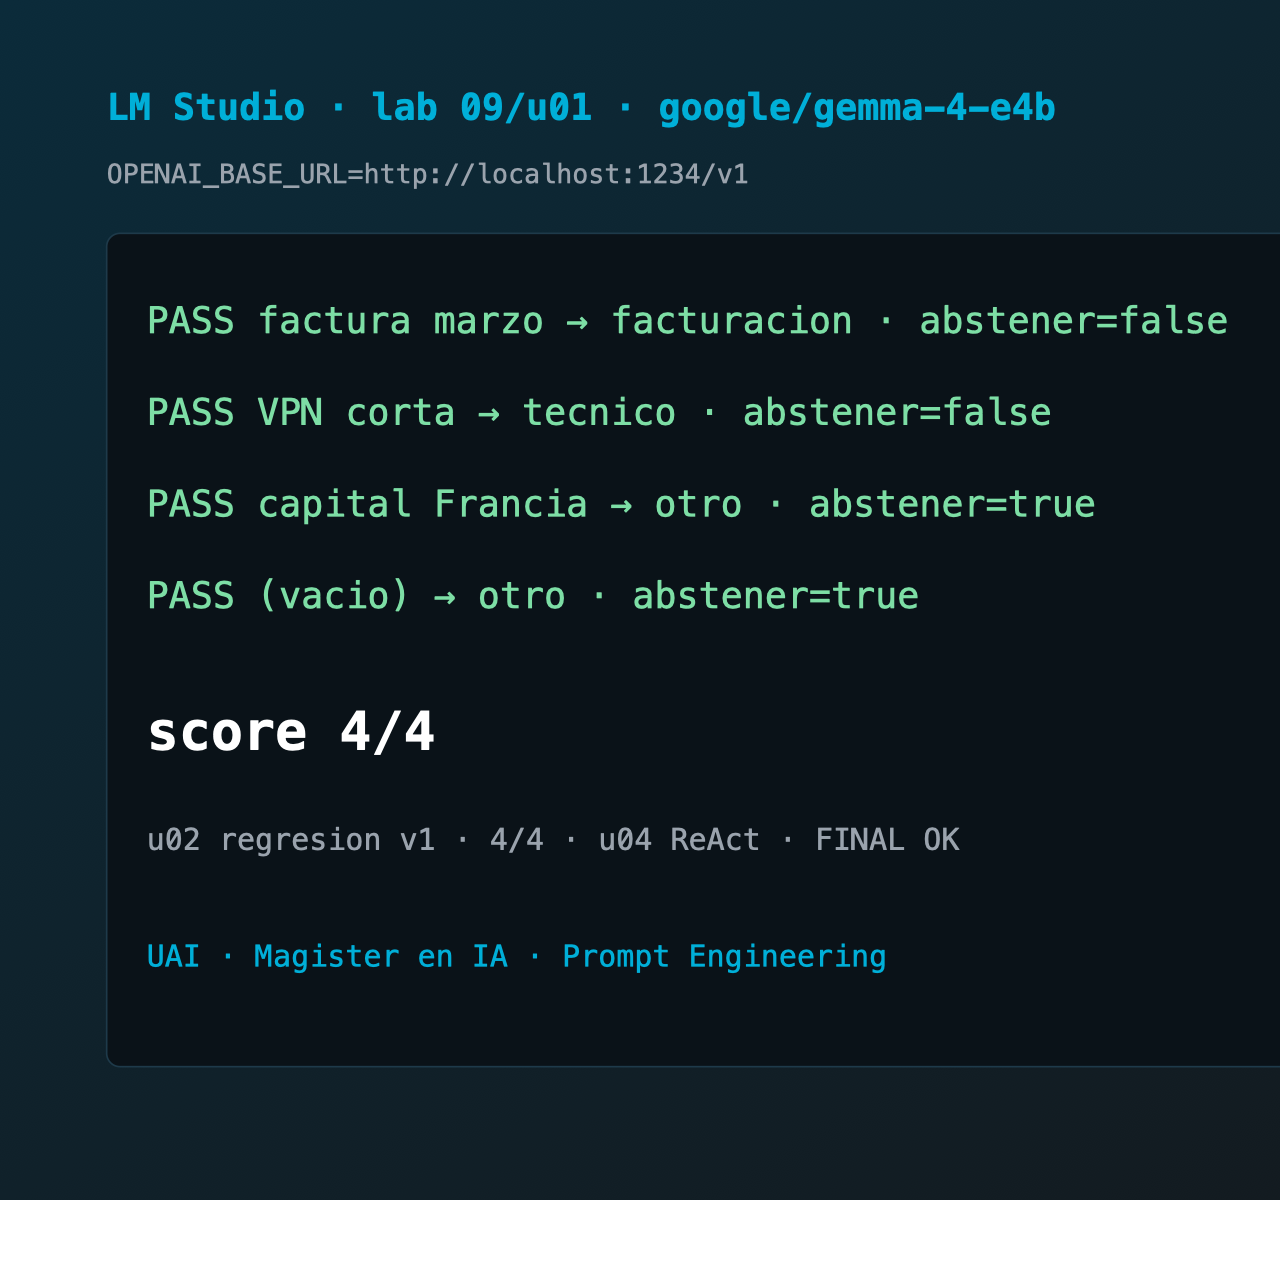
Labs locales medibles

Evidencia lab local

Lab: labs/09/ — rúbrica formato·calidad·seguridad·costo · sin datos productivos

Entregable

Suite de robustez del agente

  • Caso Chile: mail phishing a mesa de ayuda — inyección indirecta + expectativa de bloqueo.
  • Correr make lab-09-u04 (o script del agente) y adjuntar traza.
  • Una página: qué controló el runtime vs qué quedó solo en el prompt.

Lecturas

Para profundizar

  • Greshake et al. (2023) — greshake2023injection
  • Kapoor et al. (2024) — kapoor2024agents
  • Zheng et al. (2023) — zheng2023judge

Cierre


Preguntas

Puente a Diseño de Sistemas (curso 10) y AI.Ops (curso 11)