Magíster en Inteligencia Artificial
Salir de la clase

Curso 09 · Unidad 1


Instrucción como especificación

4 hrs · Prompt Engineering y Sistemas Multiagentes — UAI

Tesis de la sesión

Escribir un prompt es especificar

  • El lenguaje natural no tiene semántica precisa.
  • El destinatario no es determinista.
  • El prompt es una capa: el contexto de inferencia también incluye tools, retrieval e historial.
  • La disciplina viene del método, no de la herramienta.

Al finalizar

Resultados de aprendizaje

  • Estructurar rol, contexto, tarea, restricciones y formato.
  • Seleccionar y ordenar ejemplos few-shot con criterio.
  • Especificar salida estructurada validable.
  • Diseñar vía de abstención explícita.
  • Detectar errores característicos de especificación.

Bloque 1 · 60 min

Componentes

Componentes

Anatomía de un prompt

  • Rol — quién es el modelo para esta tarea.
  • Contexto — qué necesita saber (mínimo útil).
  • Tarea — qué debe producir.
  • Restricciones — qué no debe hacer / límites.
  • Formato — cómo se entrega la respuesta.
  • Ejemplos — few-shot cuando aportan señal.

Ilustración

Seis capas de la especificación

La tarea es el núcleo; el resto acota semántica, riesgo y parseo.

Marco

Prompt ⊂ contexto de inferencia

Escribir el prompt es necesario; curar qué entra al contexto cada turno es el siguiente oficio.

Transfer

Bloat → compaction

Misma señal (folio), menos tokens, PII enmascarada — capa de presentación UAI sobre el patrón CS329Z/Anthropic.

Definiciones

Ingeniería de contexto

  • Context engineering — curar qué entra a la ventana cada turno (prompt, tools, retrieval, historial, memoria); el prompt es una capa.
  • MCP — Model Context Protocol: interfaz estándar para exponer tools/recursos al modelo sin acoplar el prompt a un vendor.
  • Bloat de contexto — información irrelevante que diluye la tarea (Anthropic / CS329Z: focus + continuity).
  • Compaction — resumir o enmascarar historial/tool output para preservar señal y caché.

Errores frecuentes

Qué suele romper la especificación

  • Instrucciones contradictorias.
  • Solo restricciones negativas (“no hagas X”).
  • Sobrecarga de contexto irrelevante.
  • Formato pedido pero sin vía de fallo.

Bloque 2 · 60 min

Few-shot

Teoría

Few-shot como aprendizaje en contexto

  • Brown et al. (2020): el LM grande puede “aprender” la tarea desde ejemplos en el prompt (§§1–3).
  • Schulhoff et al. (2024), Prompt Report §§1–2.2: taxonomía de componentes y evidencia de qué ayuda (y qué no).
  • Orden, formato y cobertura de casos límite suelen pesar más que “más ejemplos”.

Evidencia

Aprendizaje en contexto

  • Cero / uno / pocos ejemplos: no siempre “más es mejor”.
  • Distribución y formato de los ejemplos suelen importar más que la corrección puntual.
  • El orden de los ejemplos puede sesgar la salida.
  • Elegir ejemplos que cubran casos límite, no solo el caso feliz.

Bloque 3 · 60 min

Salida estructurada

Producción

Formato validable

  • JSON / schema explícito.
  • Validación + reintento acotado.
  • Comportamiento ante entradas fuera de alcance.
  • Abstención como salida legítima → menos invención.

Producción

Abstener también es una salida

Schema + abstención OOD: menos invención, más contrato operable.

Demo viva

Misma tarea, dos especificaciones

Mostrar un prompt vago vs uno con schema + abstención. Medir tasa de parseo OK en 10 entradas (incluidas OOD).

Lab: labs/09/u01/run_structured.py contra LM Studio (google/gemma-4-e4b · localhost:1234).

Lab: labs/09/u01/run_compaction.py — historial SII/boletas crudo vs compactado; make lab-09-u01-compaction → labs/09/runs/u01-compaction-report.json.

Evidencia local
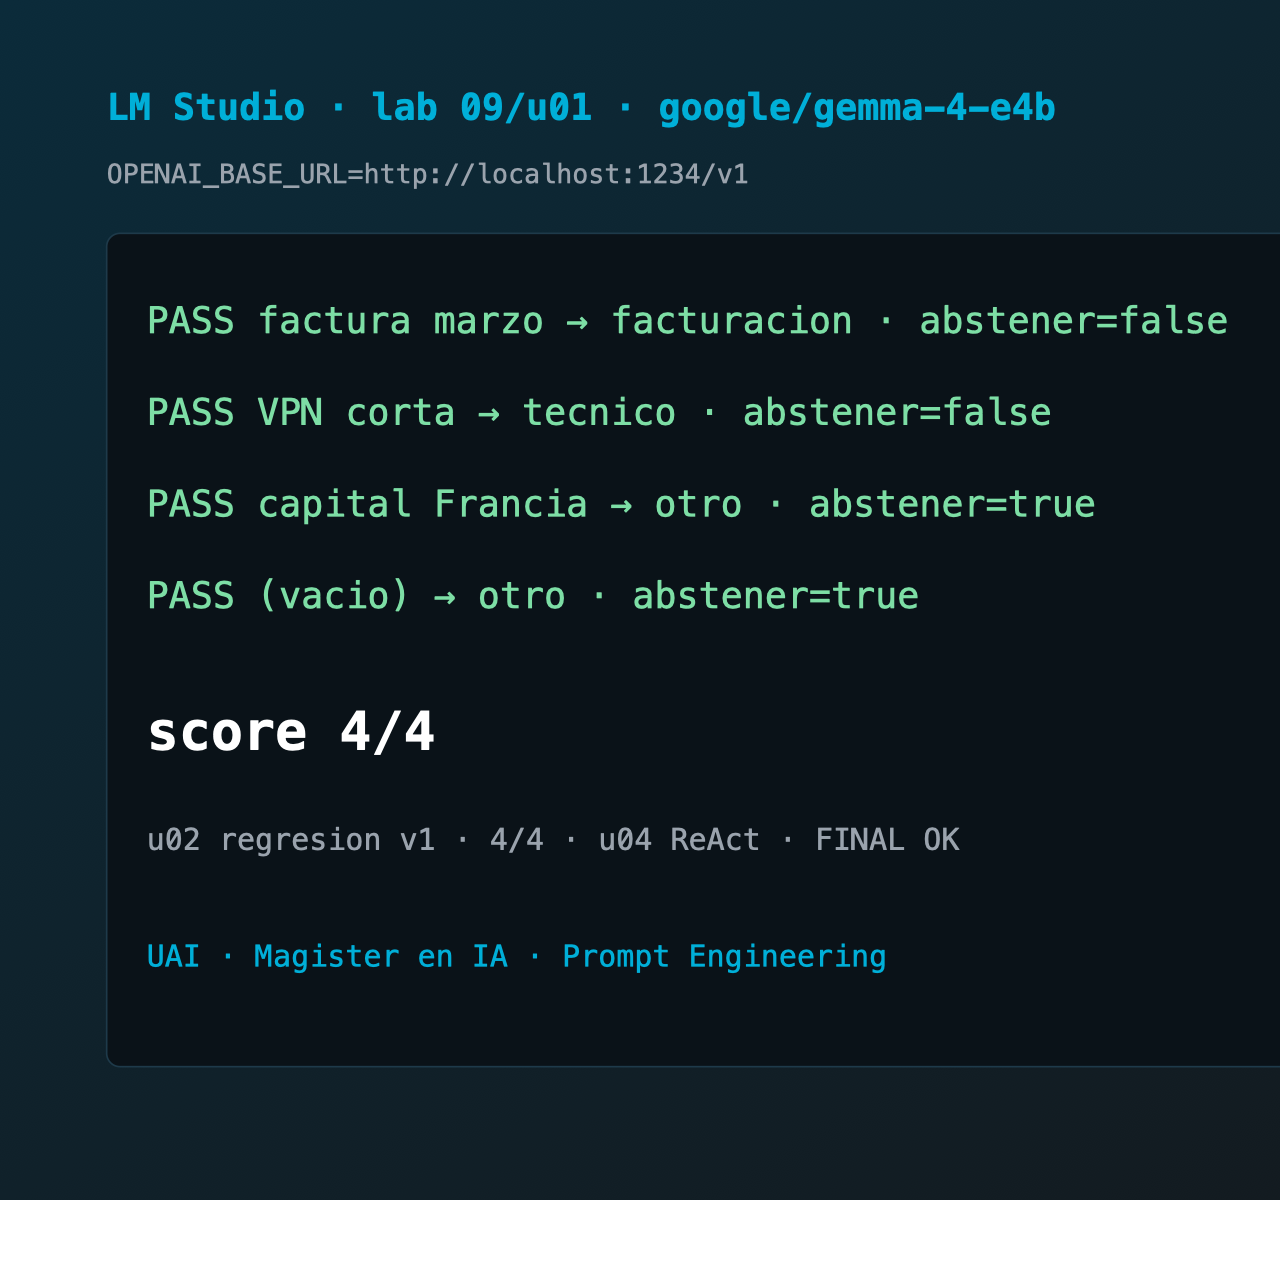
Corrida real · score 4/4

Salida del lab u01 contra LM Studio: cuatro casos PASS

Incluye abstención OOD y mensaje vacío · labs/09/runs/

Bloque 4 · 60 min

Taller

Taller

Construir y probar

  • Prompt con formato estricto para una tarea acordada.
  • ≥ 8 casos de prueba, incluidos fuera de alcance.
  • Registrar modelo, temperatura y tasa de éxito.
  • No alcanza con “se ve bien” en dos corridas.

Lecturas

Para profundizar

  • Schulhoff et al. (2024), The Prompt Report — schulhoff2024prompt (§§1 y 2.2)
  • Brown et al. (2020), Language models are few-shot learners — brown2020fewshot (§§1–3)

Cierre


Preguntas

Siguiente: el prompt como artefacto versionado (Unidad 2)