Magíster en Inteligencia Artificial
Salir de la clase

Curso 08 · Unidad 1


Arquitectura del transformer

4 hrs · Generative AI y LLMs — UAI

Tesis

El modelo es un artefacto con física

  • Generación autorregresiva explica muchos “errores”.
  • La tokenización condiciona español, números y costo.
  • Temperatura y top-p son controles de muestreo, no magia.
  • Escalar no sustituye evaluación de dominio.

Al finalizar

Resultados de aprendizaje

  • Explicar generación autorregresiva y atribuir comportamientos.
  • Determinar efectos de la tokenización en español y en costo.
  • Configurar decodificación (temperatura, top-p) según la tarea.

Bloque 1 · 60 min

Del LM al transformer

Arquitectura

Piezas que importan en clase

  • Modelado autorregresivo: P(x_t | x_<t) (Brown et al., 2020).
  • Atención y costo O(n²) con la longitud (Vaswani et al., 2017).
  • Decoder-only vs encoder: implicancias de uso.
  • KV-cache: por qué el prefijo se reutiliza en decode.

Ilustración

Generación token a token

Cada token condiciona al siguiente; un error temprano se propaga.

Teoría

Qué fijó el transformer

  • Vaswani et al. (2017): atención como mecanismo central, sin recurrencia.
  • El paralelismo en entrenamiento no elimina el costo cuadrático en contexto.
  • En clase usamos decoder-only: generación condicionada al prefijo.

Bloque 2 · 60 min

Tokenización y contexto

Evidencia

Lost in the middle

  • Liu et al. (2024): el desempeño cae cuando la evidencia está en el medio del contexto.
  • Implicancia: más tokens ≠ mejor retrieval si el orden es malo.
  • Diseño: poner lo crítico al inicio/fin o recuperar menos y mejor.

Ilustración

Dónde poner la evidencia

Inicio y fin se usan mejor; el medio es el punto ciego típico.

Práctica

Lo que se mide en el lab

  • Mismo párrafo en español vs inglés: conteo de tokens.
  • Números y nombres propios: fragmentación.
  • Ventana de contexto y degradación por posición.

Bloque 3 · 60 min

Decodificación

Control

Temperatura, nucleus, formato

  • Temperatura baja: más estable, menos diversidad.
  • Top-p: recorta la cola de la distribución.
  • Salida estructurada: schema + validación.
  • Determinismo completo no está garantizado entre runtimes.

Definiciones

Léxico de decodificación

  • Generación autorregresiva — cada token se muestrea condicionado a los anteriores P(x_t | x_<t).
  • Temperatura — reescala la distribución; baja → más pico; alta → más plana.
  • Top-p (nucleus) — descarta la cola de probabilidad acumulada fuera del umbral p.
  • KV-cache — reutiliza claves/valores del prefijo en decode para no recomputar atención.

Muestreo

Temperatura cambia la forma

Elegir temperatura/top-p es diseño de tarea, no “creatividad”.

Lab local
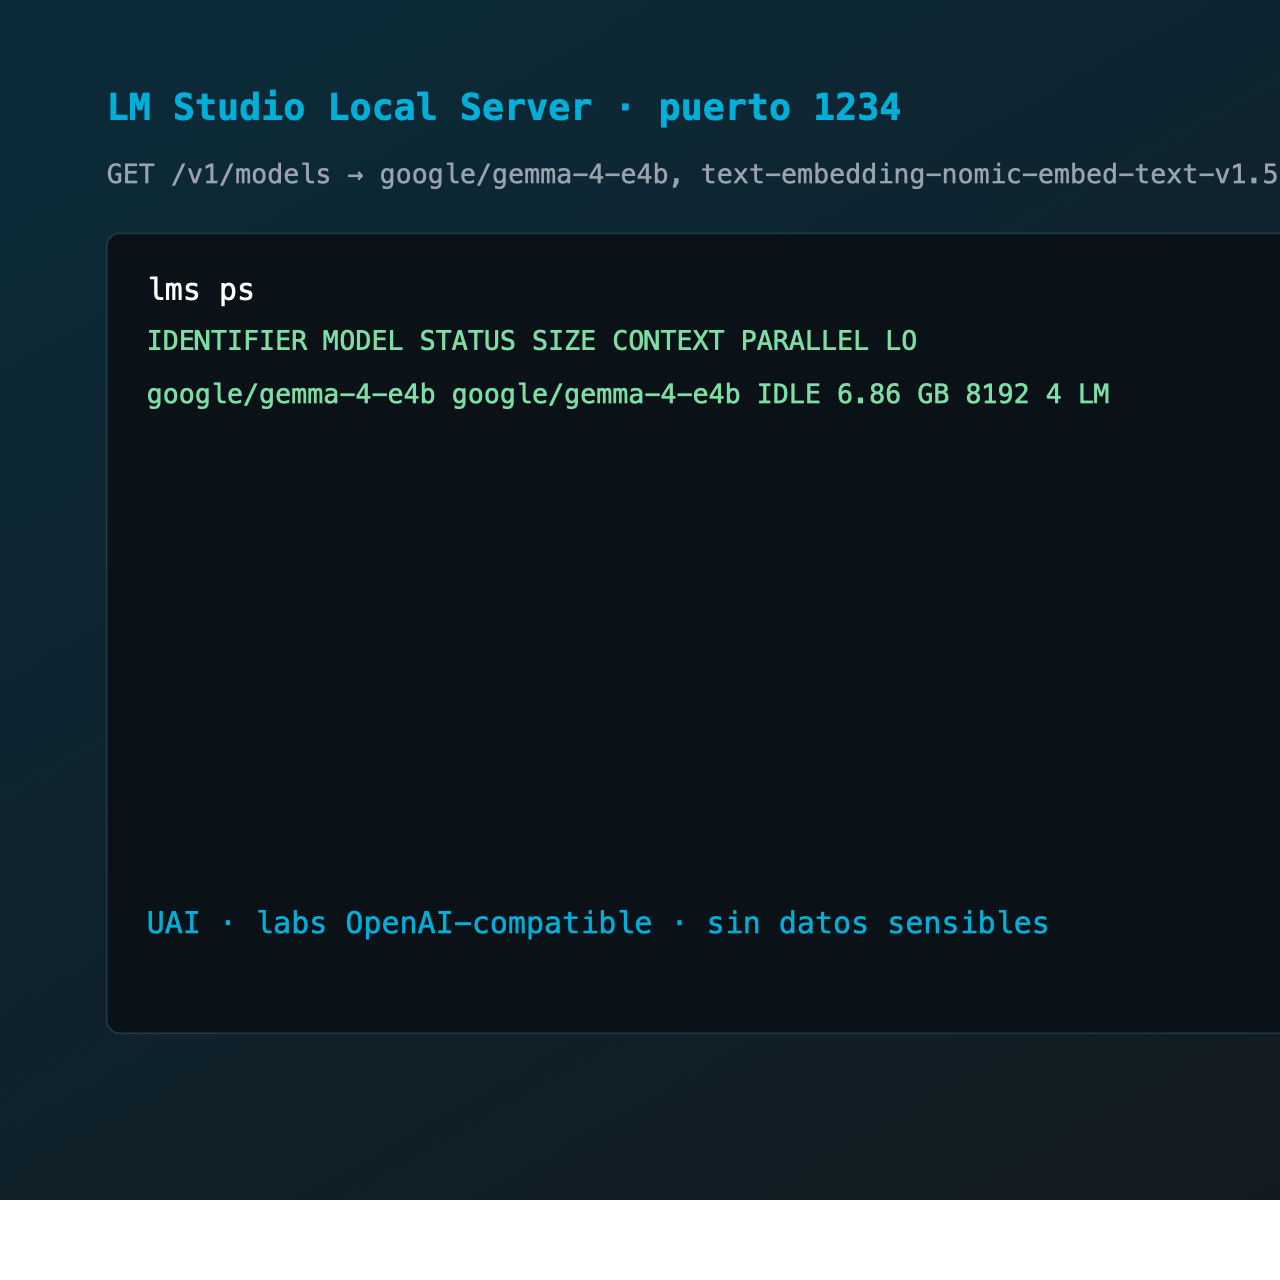
Inferencia en LM Studio

Servidor LM Studio con modelo gemma-4-e4b cargado

Misma API OpenAI-compatible que usarán los labs del curso 09

Bloque 4 · 60 min

Escalamiento

Leyes

Cómputo, datos y parámetros

  • Kaplan / Chinchilla: asignación de cómputo entre tamaño y tokens.
  • Más parámetros ≠ mejor para tu tarea sin evaluación de dominio.
  • Cuantización local: trade-off calidad/latencia/VRAM.
  • Taller: registrar temperature/top_p × diversidad en 10 corridas.

Lab

Probe de decode

  • Lab: labs/08/u01/run_decode_probe.py — temperature/top_p × diversidad.
  • Registrar 10 corridas; anotar tokens ES vs EN si aplica.
  • Eval-first: formato (log) · calidad (diversidad) · costo (tokens).

Lecturas

Para profundizar

  • Vaswani et al. (2017), Attention Is All You Need — vaswani2017attention
  • Liu et al. (2024), Lost in the Middle — liu2024lostmiddle
  • Brown et al. (2020) §§1–3 — brown2020fewshot (marco autorregresivo)

Cierre


Preguntas

Siguiente: pipeline de post-entrenamiento (Unidad 2)